No post do widescreen o port nativo de Saint Seiya: The Hades ficou com a imagem em 16:9. Desde então passei a semana em um trabalho menos visível: deixar as lutas mais leves, caçar o único crash que ainda acontecia e preencher o que faltava no som e no vídeo. Vou contar na ordem em que aconteceu, porque cada passo preparou o seguinte.
Onde o tempo ia
O port tem uma thread que faz o papel do chip gráfico do PS2 (o GS) e roda o VU1, a unidade vetorial que transforma os modelos 3D. Numa luta entre dois Mu, essa thread usava 88% de um núcleo da CPU. Não é problema para uma máquina rápida, mas sem folga nenhuma.
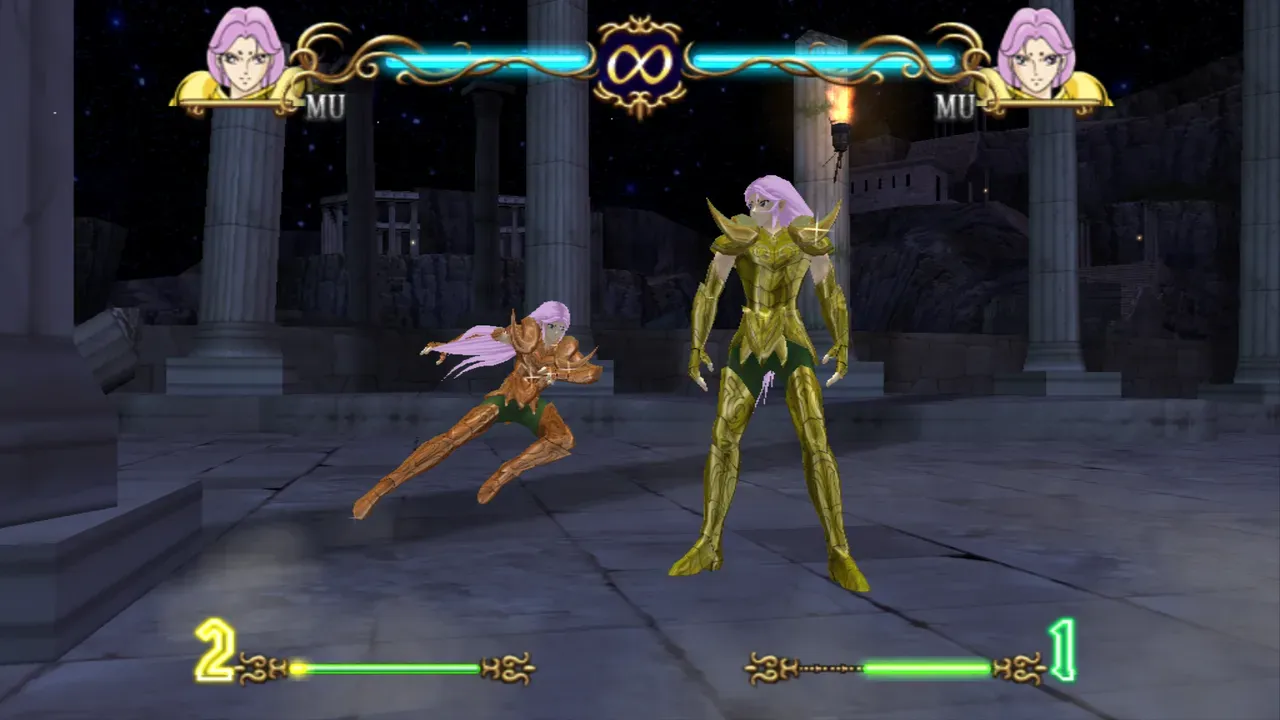
A folga importa por um motivo que demorei a ver. A cada quadro, o jogo espera a thread do GS terminar o quadro anterior antes de seguir. Se ela passa de 16,7 ms, o jogo perde o vblank e a luta cai para 30 fps. Não existe uma trava de 30 fps no jogo: assim que a thread volta para baixo de 16,7 ms, ele volta a 60. Então o custo dessa thread por quadro é o que decide entre 60 e 30, e não a CPU livre no total.
Comecei medindo. O perf mostrou os programas do VU1 em cerca de 30% dessa thread, com o resto espalhado pela emulação do GS, então não havia um único culpado. Fui ponto quente por ponto quente, um commit para cada:
- Busca do programa do VU1. Um overlay já visto não precisa percorrer o código de novo. O tempo de busca por quadro foi de 0,67 para 0,08 ms.
- Decodificação de texturas. Um laço por formato, a paleta expandida uma vez e a linha calculada uma vez por linha. Conferi com a decodificação antiga em cerca de 9.700 texturas de uma luta, e nenhum texel difere.
- Busca de texturas. O hash de cada página de 8 KB fica guardado até algo escrever nela, então a busca não percorre mais centenas de versões de página.
- UNPACK e uploads de 8 bits com SSE4.1 e
pshufb. - Comandos do VIF com todos os dados já no pacote rodam dali, sem a cópia para o buffer do VIF.
As threads do port também ganharam nomes (game, gs, ee-N, iop-N, vblank, vu-compiler). Parece detalhe, mas é o que permite filtrar o perf por thread e saber no top e no gdb quem está fazendo o quê.
Essa primeira rodada levou a thread do GS de 88% para 59% de um núcleo. Um aviso que escrevi no commit e repito aqui: a luta é diferente a cada execução, então os totais variam tanto entre duas execuções do mesmo build quanto entre builds. As proporções acima vêm dos perfis, não de uma execução de sorte.
Programas do VU1 compilados antes do jogo começar
O port já traduzia os programas do VU1 para código nativo, mas fazia isso em segundo plano enquanto você jogava, e um programa de que o jogo precisava logo podia rodar antes no interpretador (cerca de 5 vezes mais lento).
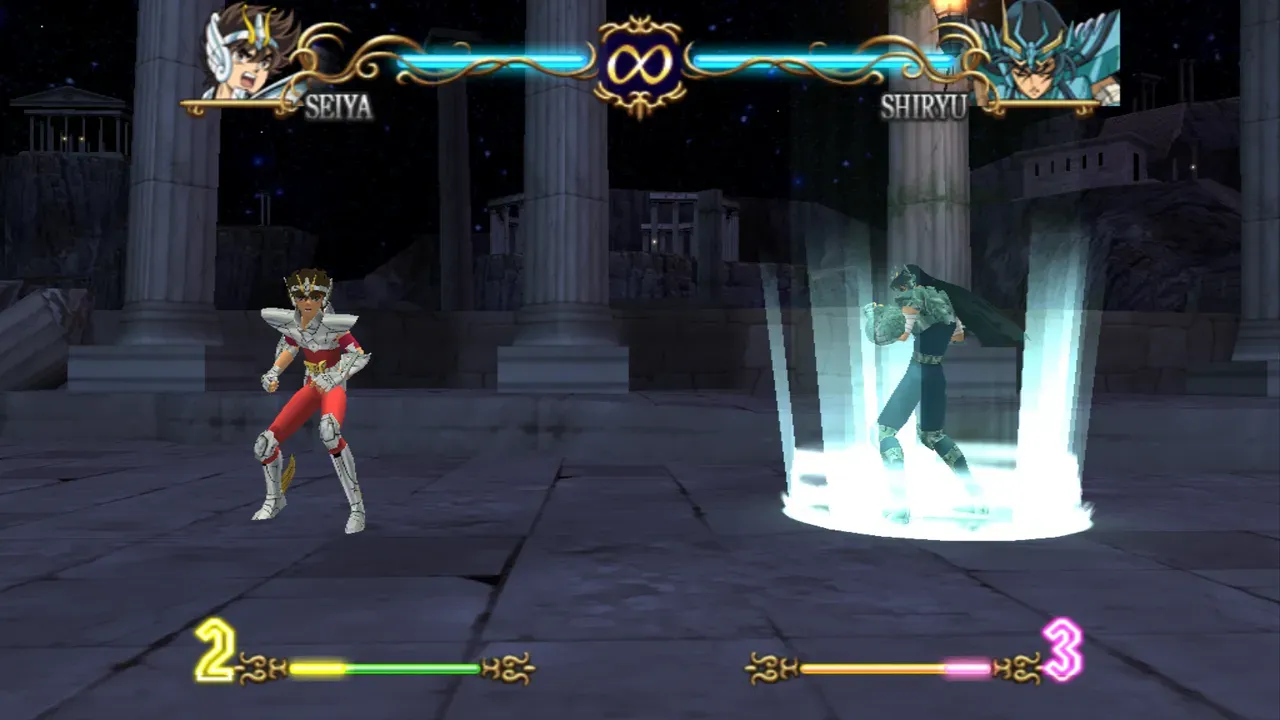
Todo o código do VU1 do jogo está no executável, em pacotes de DMA que o jogo manda para a memória de código do VU1: uma parte residente e 56 overlays carregados no mesmo endereço (0x33B0). Então, em vez de esperar para ver quais o jogo roda, o port agora acha todos os pontos onde um programa pode começar: o primeiro par de instruções, o par depois de um bit E (o fim de um programa) ou de um JR, o retorno de cada JALR e os endereços montados com IADDIU. São 189 programas. O sstheh --compile-vu compila todos (o build.sh chama isso), e com o cache já quente a checagem na partida leva cerca de 13 ms. Partindo de um cache vazio, numa luta de Mu contra Mu e numa de Seiya contra Shiryu, nenhum programa foi compilado ou interpretado durante o jogo. Para ter certeza de que a regra não deixava nada de fora, rodei os 44 lutadores do modo versus (22 lutas, apertando botões) e duas partidas do modo história, e o cache ficou com exatamente os mesmos 189.
O passo seguinte foi melhorar o C gerado. Os overlays chamam as sub-rotinas residentes com IADDIU mais JALR, para endereços constantes, então o tradutor consegue seguir a chamada e manter ela e o seu retorno numa única função nativa: cerca de 7 saltos por execução de programa viraram nenhum. As flags MAC e de status agora só são calculadas onde algo pode lê-las: no VU, uma instrução enxerga as flags de quatro pares antes, então dá para saber, olhando o programa, quais nunca são lidas. Os contadores do Q e do P (os resultados de divisão e das funções do EFU, que chegam alguns ciclos depois) também só andam onde existe um resultado a caminho. FTOI e CLIP foram vetorizados, porque passavam pela memória faixa por faixa e travavam em store forwarding.
Código mais rápido só vale se continuar sendo o mesmo código, então escrevi um bench (tools/vubench.c). Ele repete 11.573 execuções de programa gravadas numa luta e compara registradores e memória de dados com o resultado do próprio jogo no fim de cada execução, também com as flags herdadas embaralhadas. Os ciclos dessas execuções foram de 62,6 M para 29,9 M. No jogo, o tempo do VU1 por quadro, contando o desenho, foi de 7,8-8,6 ms para 6,3-6,4 ms. De brinde, os 189 programas passaram a compilar em cerca de 20 s, e não 35.
Para este post gravei uma luta nova de Mu contra Mu com o build atual e rodei o bench de novo:
12059 runs, 0 not native, 0 end differently from the game12059 runs, 0 not native, 26.7 Mcycles from 000: 4299 runs, 0.16 Mcycles from 3B8: 1453 runs, 0.79 Mcycles from 2188: 1071 runs, 4.56 Mcycles from 33B0: 2390 runs, 20.39 Mcycles ...A linha de baixo explica para onde olhar daqui para frente: os programas que começam em 0x33B0, o endereço dos overlays, são 20% das execuções e 76% dos ciclos. É ali que ficam as transformações pesadas dos modelos; os residentes são rotinas curtas.
Uma ressalva de método: medir o VU1 dentro do jogo engana. Gravar as execuções deixa o jogo tão lento que 20 vblanks viram uns 3 quadros, e o custo muda muito com o que está na tela (uma aura de cosmo pesa mais). Uma melhoria que pareceu não render nada no jogo, seguir os JR constantes, rendeu 13% no bench.
15.000 draws que eram 525
A thread do GS ainda gastava boa parte do tempo mandando draws para a GPU. Um quadro de luta tinha cerca de 15.000, e muitos eram a mesma tira de triângulos cortada em pedaços com o mesmo estado.
O motivo de tantos pedaços está no PS2. O GS não tem draw calls: o VU1 manda vértices em pacotes (o XGKICK), e cada pacote tem que caber nos 16 KB de memória de dados do VU1, então um modelo chega em vários pacotes. No console isso é de graça. Numa GPU de PC, cada draw é um comando com estado para conferir e amarrar, e o custo por draw é o que pesa.
Uma primitiva com o mesmo estado do draw anterior, chegando logo depois dos vértices dele, agora aumenta esse draw em vez de começar outro. Draws que leem o próprio alvo de renderização não são unidos, porque o alvo é copiado antes de cada um. Um quadro de luta foi de cerca de 15.000 draws para cerca de 525, e as amostras da thread de render numa luta de Mu contra Mu caíram de 7-8 mil para 3,2 mil.
Para confiar nisso, criei um gravador para a thread do GS: o SSTHEH_GSREC salva o que ela recebe em 150 imagens, e o sstheh --gs-replay roda de novo sem o jogo e mostra o tempo por quadro e um hash do que foi gravado para a GPU. Draws com o mesmo estado entram no hash como um só, então o hash fica igual com ou sem a união. Os três builds que comparei deram o mesmo hash, e o tempo por quadro foi de 8,66 para 7,14 e 6,95 ms. Nos 40 quadros medidos, a thread de render passou de 608.759 draws para 21.028.
O hash ignorar a união é de propósito: é o que prova que unir draws não mudou nada do que vai para a tela. Se uma união errada juntasse dois draws de estados diferentes, o hash mudaria. No mesmo commit o XGKICK passou a ler o pacote direto da memória do VU1, sem copiar 16 KB a cada envio. A gravação de hoje, no build atual, dá isto:
[vujit 0] 189 VU1 programs (resident code and 56 overlays), 0 to compile150 pictures shown (120 timed): 40 frames, 16814 draws, 6.935 ms per frame, all 425 ms, hash c2e9093a967c6e3fSão cerca de 420 draws por quadro nesse trecho da luta. O replay precisa rodar como ./build/sstheh: de outro lugar ele não acha os programas do VU1 compilados, cai no interpretador e dá outro tempo e outro hash, sem avisar.
O crash que não era um use after free
Cerca de 1 luta em 25 caía dentro da func_00155540, sempre a mesma função. Sem símbolos, um relatório de crash só com registradores ajuda pouco, então fiz ele mostrar as chamadas em andamento: as palavras acima do sp que parecem endereços de retorno, logo depois de um JAL ou JALR. É uma heurística: o código do jogo não guarda um ponteiro de quadro, então não dá para desempilhar com certeza, mas um valor na pilha que aponta para logo depois de uma chamada quase sempre é um retorno.
Depois escrevi uma ferramenta para o suspeito que eu tinha: SSTHEH_POISON_FREE=1 preenche cada bloco liberado com 0xA5 e lembra quem o liberou, então um ponteiro lido de um bloco liberado para o programa ali. Ela achou um candidato: uma transição de golpe libera os slots do golpe que sai, e uma transição posterior instanciava um golpe com um ponteiro para um desses blocos. Anotei como use after free, com “causa ainda não confirmada”.
Estava errado, e o commit que corrige diz isso. Nenhum slot foi liberado enquanto outro ainda apontava para ele. O veneno tinha achado ruído: blocos liberados de verdade, lidos por código que não tinha nada a ver com o crash.
O que mudou o rumo foi parar de olhar o código e olhar o dado. Salvei os 32 MB da RAM do jogo no momento do crash (SSTHEH_RAM_DUMP), decodifiquei o arquivo dos golpes fora do jogo e comparei com o mesmo arquivo lido do ISO. Diferiam em 295 bytes, e sempre no mesmo endereço absoluto, em toda execução. Um use after free espalha lixo onde o heap mandar; um endereço fixo é alguém escrevendo sempre no mesmo lugar. O que quebrou foi o dado: o arquivo dos golpes especiais do Aiacos estava corrompido na RAM, e o golpe 23 decodificava para lixo cujo script travava.
A corrupção era minha. Os handlers de interrupção rodavam numa pilha em 0x01F00000, 1 MB abaixo do fim da RAM. Quando escrevi o kernel, achei que aquilo era espaço livre abaixo da pilha da thread principal. Não era: o jogo distribui o heap até 0x01F80000, onde começa essa pilha. Cada interrupção escrevia cerca de 0x140 bytes em 0x01EFFEC0..0x01EFFFF7, por cima do que o jogo tivesse ali, e nas lutas era o arquivo. Como a pilha cresce para baixo, os bytes caíam logo abaixo de 0x01F00000. No console, os primeiros 512 KB da RAM (0x00000000 a 0x0007FFFF) são do kernel, e o jogo carrega a partir de 0x00100000, então movi a pilha para 0x00080000, o topo dessa área. Com isso, o arquivo na RAM ficou idêntico ao do ISO, e 18 lutas rodaram sem crash.
Faça o relatório de crash dizer o que estava rodando.
A cadeia de chamadas pela pilha apontou para uma função de script.Teste o suspeito com uma ferramenta, não com um palpite.
O veneno achou algo que parecia a causa.Compare o dado com a origem.
O arquivo na RAM tinha que ser igual ao do ISO, e não era, o que um use after free não explicaria.Pergunte quem mais escreve ali.
O único que escrevia era a minha própria pilha de interrupção.
O mesmo código, resultados diferentes
Ao comparar os programas traduzidos com o interpretador, o vubench check apontou 997 de 8.771 execuções terminando diferentes. A causa era o compilador: com -march=native, o GCC transforma _mm_add_ps(_mm_mul_ps(...)) em um fused multiply-add. Um arredondamento em vez de dois, e o VU faz dois. Os dois caminhos davam resultados diferentes para o mesmo programa.
Isso não é um bug do GCC. O padrão do C permite contrair a * b + c, e no modo GNU (o padrão do GCC) a opção é -ffp-contract=fast, que contrai sempre que a CPU tem FMA. Com -march=native numa CPU moderna, tem. O pior é que isso acontecia nos programas traduzidos e em partes do interpretador, então nenhum dos dois era uma referência confiável. O código MIPS recompilado do jogo não tinha nenhum FMA, porque cada operação de ponto flutuante dele passa por uma função própria do port.
-ffp-contract=off para o port, os programas traduzidos e o bench resolveu: 0 de 8.220 execuções diferentes, e cerca de 2% mais ciclos do VU1. A versão do gerador subiu (GEN_VERSION 12) para que os programas já compilados com FMA fossem refeitos. Isso também me fez mudar o cache dos programas compilados. Eles são nomeados por um hash, então nada dizia quais um gerador antigo tinha deixado, e o cache só crescia (54 MB e 1.546 arquivos para 189 programas em uso). Agora ficam em ~/.cache/sstheh/vu/<versão>, onde a versão também cobre as flags do compilador, e as versões antigas são removidas na partida.
Reverb e o vídeo de abertura
Faltavam duas coisas no som e no vídeo, e as duas eram coisas que o jogo faz sozinho.
O jogo liga o efeito do SPU2 nos cenários e nos menus, e o port misturava só as vozes secas. A área de efeito agora roda como o reverb do PS2: os filtros comb e all-pass e as reflexões da fórmula do PSX na metade da taxa, com os dez presets do SDK, os envios de efeito das vozes e a mistura molhada na saída quando o core habilita.
O reverb do SPU2 não é um efeito à parte: ele usa um trecho da própria RAM de som como linha de atraso. O jogo diz onde fica esse trecho (do ESA ao EEA) e qual preset usar pela sceSdSetEffectAttr, e cada preset é uma tabela de deslocamentos dentro dele, em unidades de 8 bytes. O hardware roda a fórmula a cada duas amostras, lendo e escrevendo nesse buffer, por isso “na metade da taxa”. O modo 0x100 só limpa a área.
O único vídeo do jogo é a abertura, um MPEG-2 de 85 segundos que toca depois de cerca de 80 segundos na tela de título. O Sofdec decodifica com o IPU do PS2, que o port não tem, então a tela ficava preta e o vídeo nunca terminava. O passo da cena agora é substituído: o arquivo é lido da imagem do disco e decodificado com libavformat e libavcodec numa thread própria. A imagem toma o lugar da do jogo, o som é misturado com o do jogo, o START pula, e no fim a cena termina do jeito que o jogo a termina. Sem o FFmpeg na hora de compilar, o vídeo é pulado.
O arquivo é DATA/GX_JP.SFD: MPEG-2 em 512×448, 25 quadros por segundo, com o som em ADX. Procurando por ele achei também um GX_MAIN.SFD de 1,9 GB, que parecia o vídeo em alta qualidade. São só zeros, um arquivo de enchimento que ocupa o resto do disco. No port, o passo da cena (0x002C3740) é trocado por uma função nossa, que conversa com o resto do jogo do mesmo jeito que a original.
Dois acertos
O widescreen tinha uma falha: em quadros com 3D chegando nas laterais do 16:9, todo o 2D ficava em 4:3, então um fade branco sobre uma cena 3D clareava só o meio e as faixas da tela de VS paravam antes da borda. Agora, um draw 2D que cobre a largura inteira do quadro e é uma faixa (no máximo 35% da altura), sem textura ou com textura de uma cor só, é esticado junto com o 3D. Imagens, como o Seiya do menu principal, mantêm a forma, e o HUD da luta continua em 4:3.
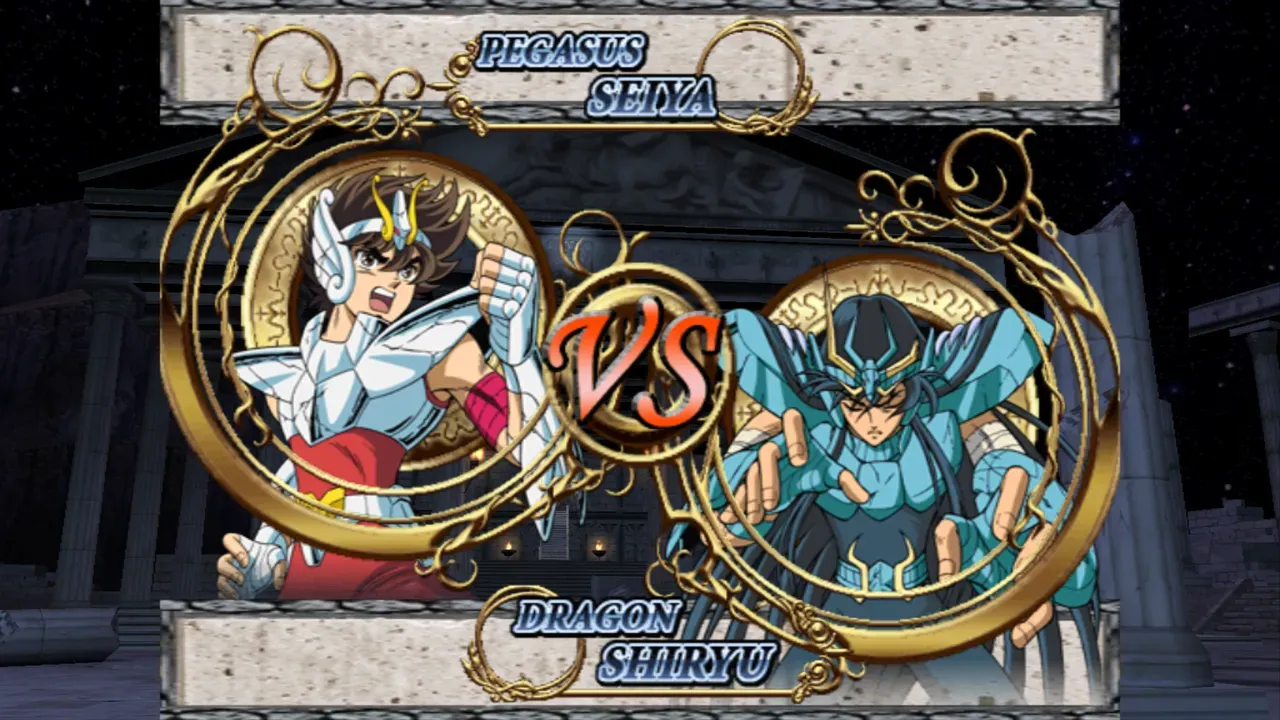
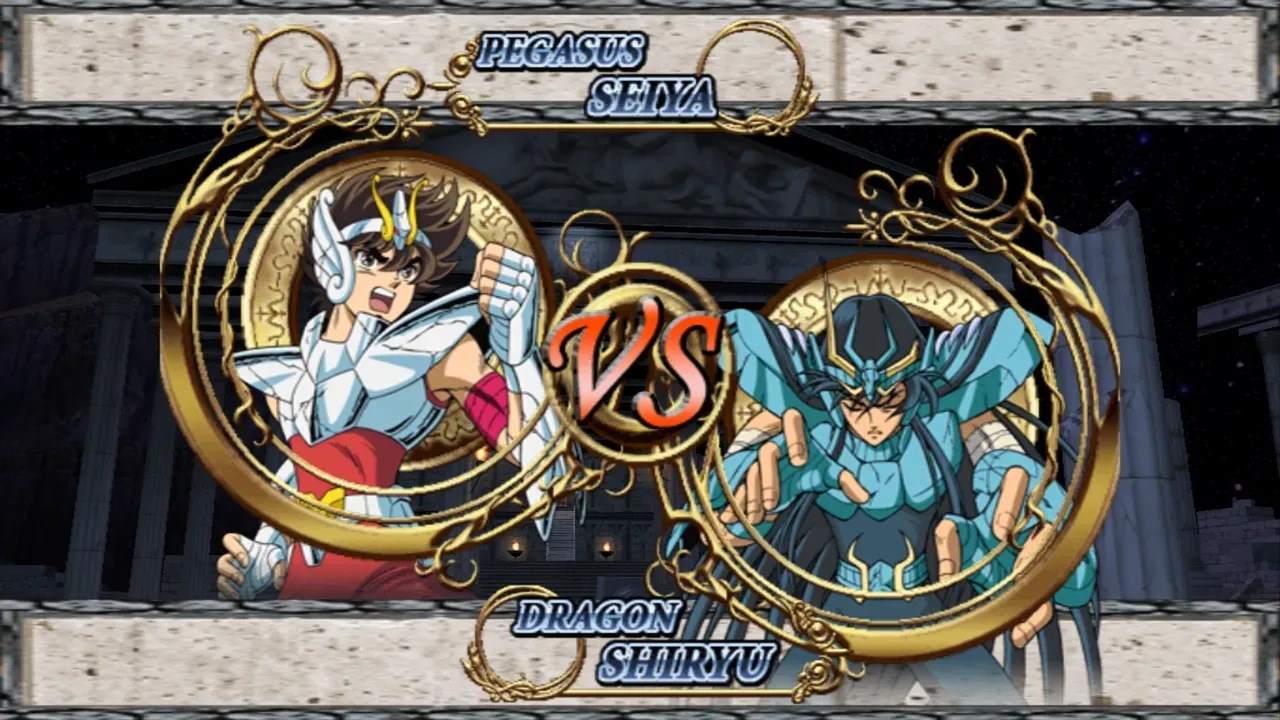
“Uma cor só” tem uma definição concreta: cada texel a no máximo 8 níveis do primeiro, em cada canal. A conta é feita uma vez, quando a textura é decodificada, e fica guardada com ela, então não custa nada por quadro. A tolerância existe porque um fade “branco” quase nunca é branco exato. Para tirar a captura de antes, compilei o port atual com só essa regra desligada.
E agora existe um segundo controle. Só o primeiro era aberto e só a porta 1 era lida. O primeiro (junto com o teclado) joga na porta 1 e o segundo na porta 2, então os modos do jogo oferecem 1P contra 2P quando há dois conectados.
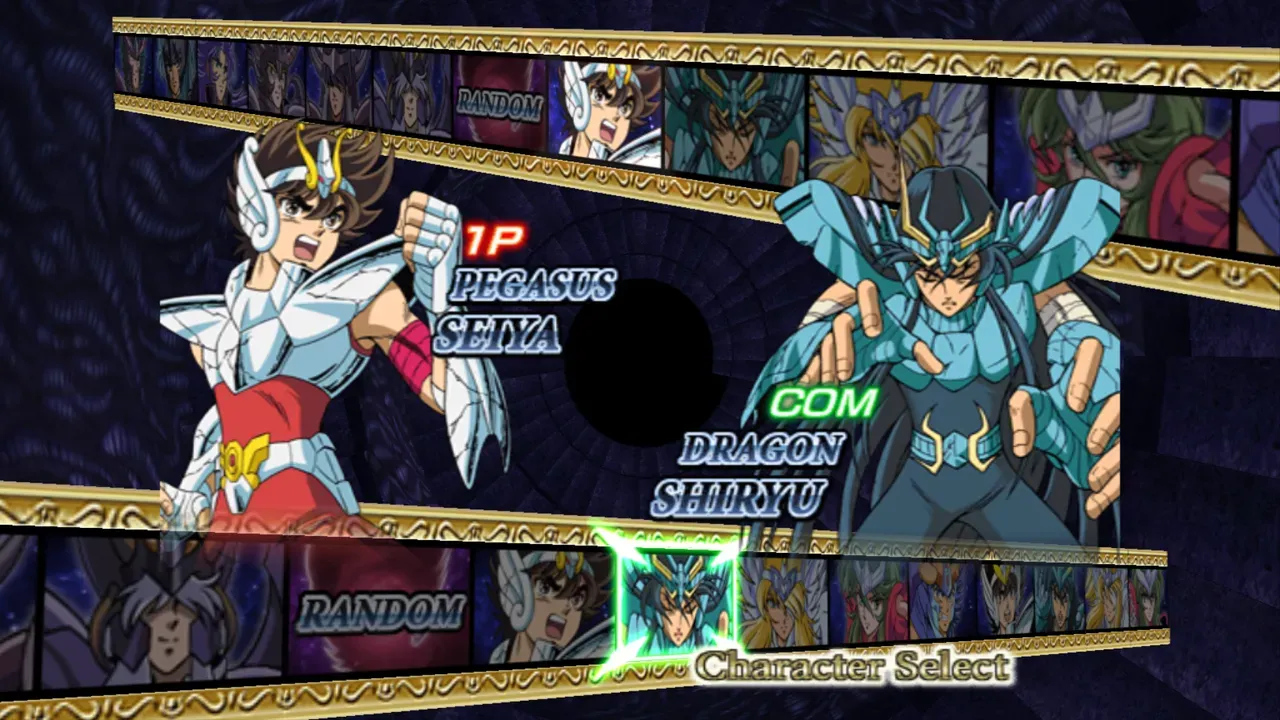
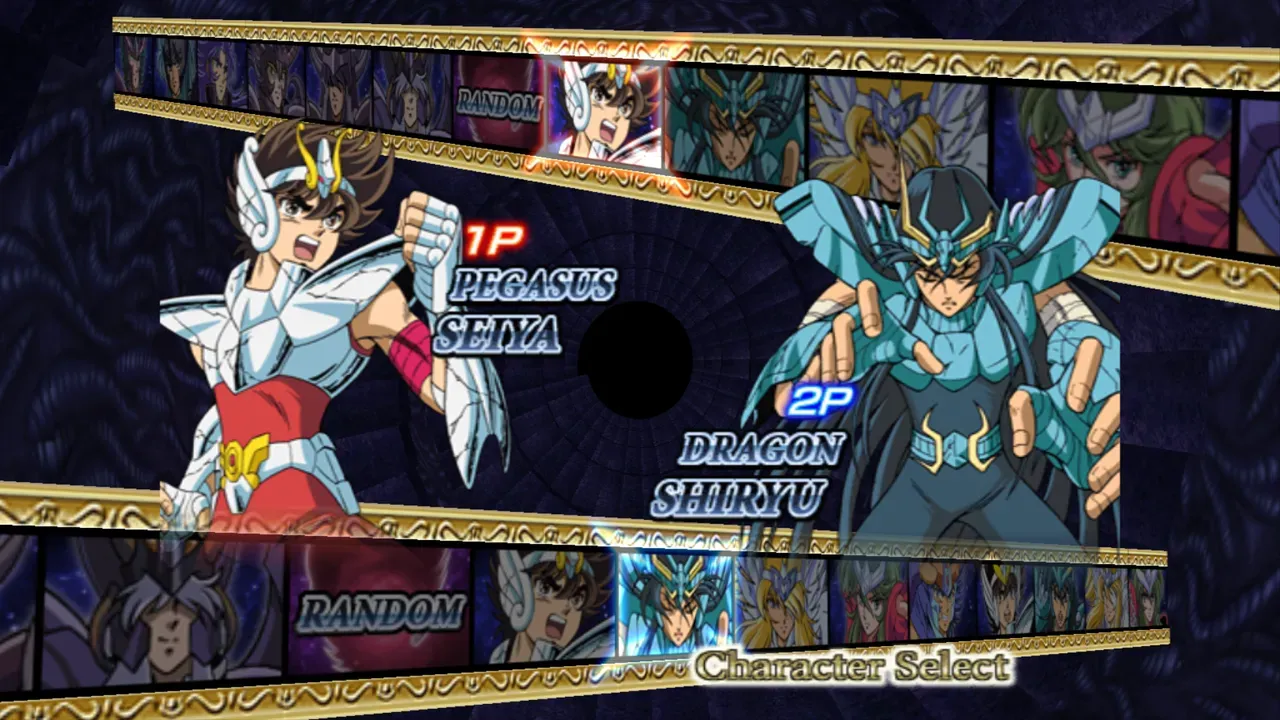
Quem decide isso é o próprio jogo. Ele pergunta ao driver de controle se existe algo na porta 2, e o port agora responde que sim enquanto houver um segundo controle conectado. Se o controle sai no meio, a porta é liberada e volta a ficar vazia. Para testar sem dois controles, SSTHEH_PAD2=1 finge que existe um, e foi assim que tirei a captura acima.
Um modo de treino
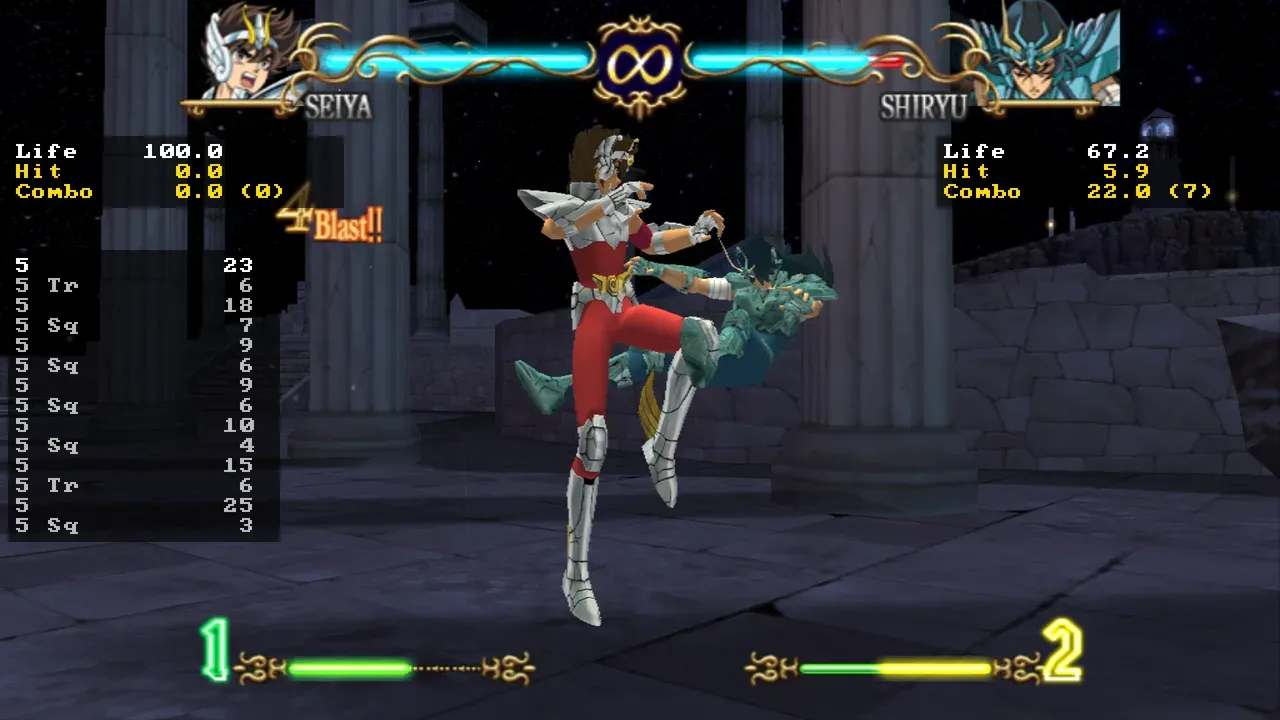
O último item da semana não existia no jogo. Num jogo de luta, aprender um personagem é repetir o mesmo combo contra alguém parado e ver quanto ele tira, e o The Hades não tem um modo para isso. O port agora tem: F5 (ou Select + Start no controle) abre um menu por cima do jogo, e com o treino ligado, em qualquer luta:
- O oponente do computador fica parado. Golpes que ele já começou terminam, mas ele não decide mais nada.
- A vida é infinita. Ela volta ao máximo um segundo depois do último golpe recebido, e nenhum golpe nocauteia.
- O dano aparece na tela: a vida de cada lado, o dano do último golpe e o do combo, com o número de acertos.
- Os comandos do jogador 1 aparecem na tela, o mais novo em cima, em notação de teclado numérico (5 é neutro, 6 é para a frente) e com quantos quadros cada um durou.
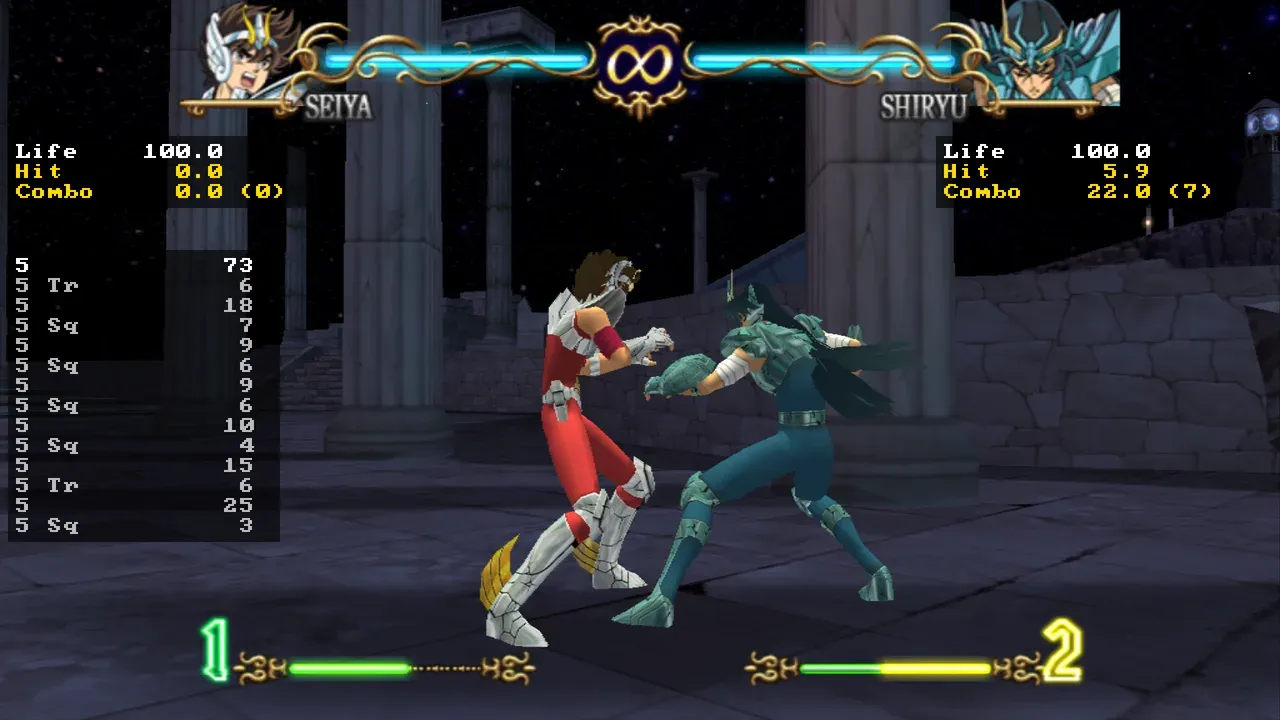
Para isso, o port precisava saber três coisas que o jogo não diz em lugar nenhum: onde fica a vida de cada lutador, onde o golpe tira vida e onde o computador decide o que fazer. Nenhuma tem nome no executável.
A vida foi achada pela imagem. Com SSTHEH_RAM_DUMP=1, cada --shot também salva os 32 MB da RAM. Tirei capturas em momentos diferentes de uma luta, medi a barra de vida em cada uma e procurei nos dumps um valor que mudasse na mesma proporção. Apareceram dois. Um é a vida dividida por 100, que o HUD usa para desenhar a barra, e escrever nele não muda nada. O outro é a vida de verdade, um float de 0 a 100: escrevendo 100 nele a cada vblank, o lutador não morria. Faltava achar quem escrevia ali, e para isso usei um watchpoint de hardware no gdb sobre aquele float da RAM emulada. Ele parou na 0x0031E5F0, que aplica todo golpe: recebe o bloco de vida do lutador e o dano base. Um detalhe dela explica o “nenhum golpe nocauteia”: a vida é limitada a no máximo 100, mas não a no mínimo 0.
Os endereços do heap mudam de uma luta para outra, então o port não guarda nenhum. São três ganchos, funções nativas que rodam na entrada de uma função do jogo e depois deixam o código original seguir:
- na
0x002F9140, o passo da luta, uma vez por quadro: lê os dois lutadores e os dois controladores, e devolve a vida a 100 quando passou um segundo sem golpe; - na
0x0031E5F0, o dano: anota a vida antes de cada golpe (o dano é a diferença) e impede o nocaute; - na
0x002FF490, o passo comum dos controladores: se o controlador é o do computador, apaga a decisão que ele acabou de tomar.
O último foi o mais bonito de achar. Os dois tipos de controlador, o do jogador (que lê o controle) e o do computador (a IA), terminam chamando a mesma função. Pelo ponteiro da tabela de métodos dá para saber qual é qual, e apagar a decisão da IA ali deixa o lutador parado sem mexer em mais nada. Contra um segundo jogador nada disso é apagado, porque o controlador é do tipo do jogador.
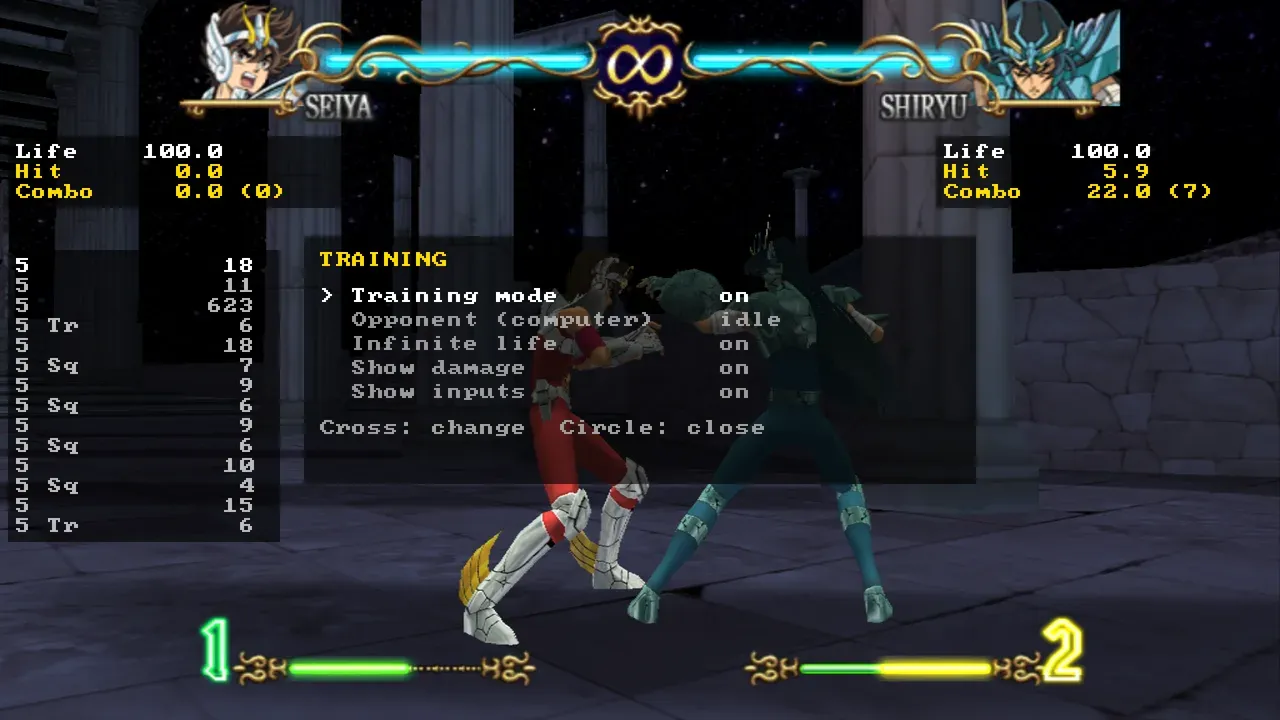
O painel é desenhado pelo renderizador de software do SDL numa imagem RGBA de 640×360 (480×360 em 4:3), que a GPU estica por cima da imagem do jogo. Como ele fica em cima do quadro já pronto, não interfere em nada do que o GS desenha, e o widescreen e a escala de renderização não precisam saber que ele existe.
O que aprendi
- Meça antes de otimizar, e meça com algo que não muda o resultado. O bench de replay e as execuções gravadas do VU me deixaram mexer em muito código comparando a saída com a original.
- Escreva o suspeito como suspeito. Meu primeiro diagnóstico estava errado, e a anotação dizia “não confirmado” por isso.
- Um bug que parece do jogo pode estar na camada de plataforma. O jogo nunca liberou nada que não devia; o meu kernel escreveu na memória dele.
- O compilador faz parte do hardware que você emula. Um fused multiply-add é uma otimização válida para o C e um resultado errado para o VU.
Ainda não feito: o pacote de texturas ampliado com IA que citei no fim do post anterior. O código está no repositório do port, que não distribui nada do jogo: cada um compila a partir do próprio disco.